一到下午,所有的大模型AI都在卡……
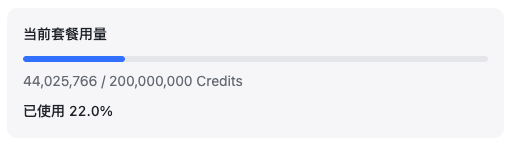
曾老师昨天买了小米的 Xiaomi MMO Token Plan(100 元档),改了两个 BUG 就剩 80 块了……

问题是,这还卡着,一个问题改 40 分钟没改完。
曾老师这是第一次希望 token 快点花完,因为 token 不动,证明模型被限流了。
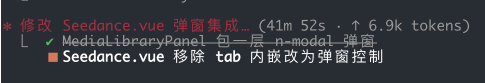
小米的 mimo-v2-pro 编程能力还是不错的,曾老师觉得差不多达到了 GLM 5.1 的水准。当然有可能是 GLM 5.1 太卡,水准发挥不正常?
一到下午,对于我这种每个模型都开一个窗口,同时干活的人来说,也无法逃过被卡住的命运,因为:
所!有!模!型!都!卡!!!
智谱的 GLM 5.1 超卖就不说了,一到下午就 429。
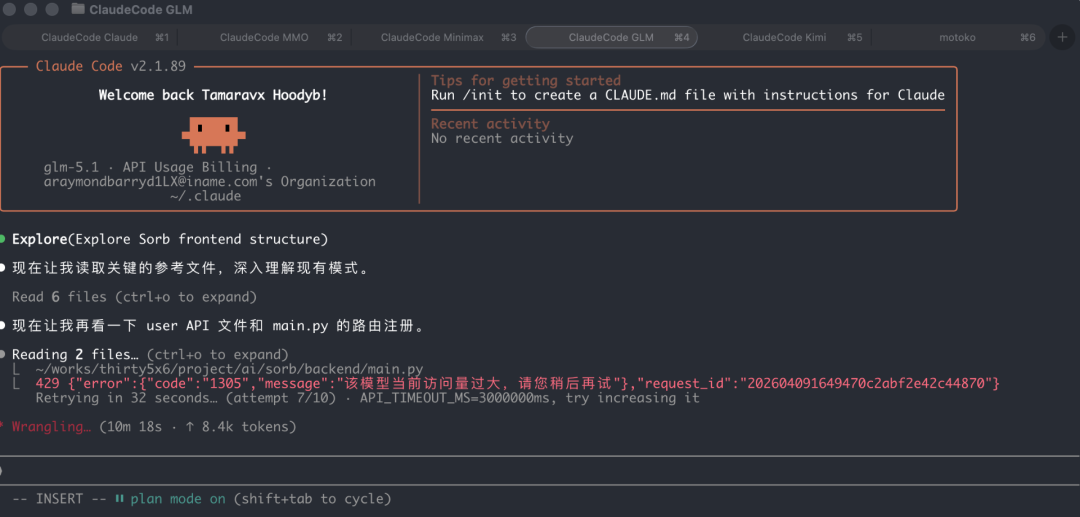
速度发挥最稳定的莫过于 MiniMax-M2.7(官方 Coding Plan),贼快贼快的,虽然有时候不太聪明:
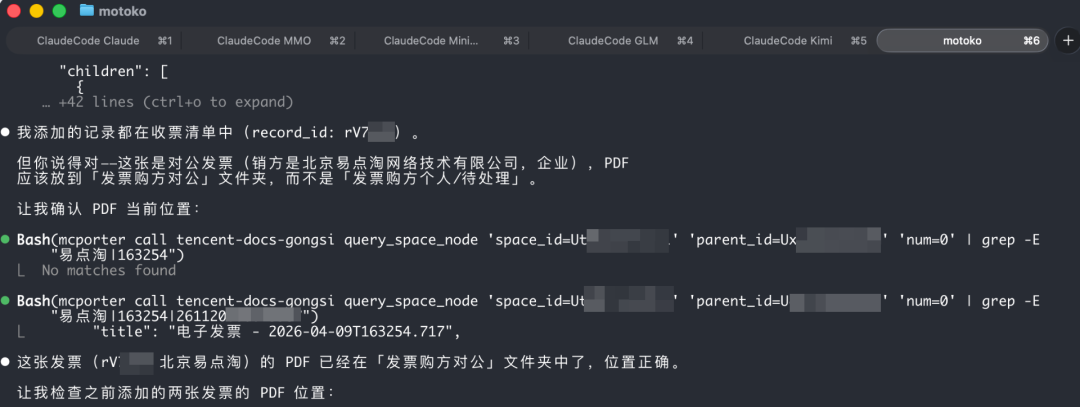
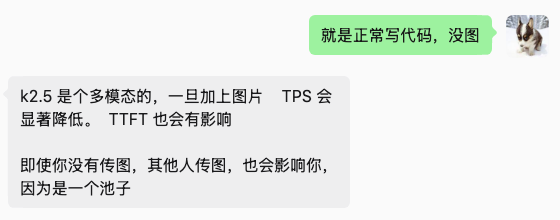
火山方舟 Coding Plan 中的 Kimi-k2.5 慢到没法用!有网友说可能在整个池子里有人传图吧。
那么,这么多模型一起用,到底哪个编程能力更强点呢?分三个层次吧:
- 在不卡的情况下,自然是 Claude Opus 4.6 断层领先。
- GLM 5.1 和 Mimo v2 Pro 大约在一个级别。Gemini 3.1 也差不多在这个级别。
- MiniMax M2.7 和 Kimi k2.5 稍弱。
这只是每个模型都烧了十几亿 Token 之后的一个整体体验,曾老师不对上面的排行结果负责。
最近曾老师的更新可能不太正常。没办法,每天和 AI 缠斗太久,被蒸馏了不少技能。
愿世界和平,愿模型不卡,愿霍尔木兹海峡早日重新开放。
#胡扯AI #AI
胡扯 AI 群,匹配游戏小团队创业,关注 AI 嵌入游戏工作流
当听到地铁上有人聊 ChatGPT,当 DeepSeek 把 OpenIAI 和 Gemini 卷到打骨折,当百度开源文心一言,我知道,将 AI 全面嵌入工作流的时机已经成熟了。
曾老师会持续专注于将 AI 深度整合进入工作流,有兴趣折腾的朋友可扫描下方二维码,一起在游戏创业路上持续精进。
「胡扯漫剧」社群关注最新的 AI 漫剧知识,技巧和搞钱方法论。
- 文章ID:2888
- 原文作者:zrong(Jacky)
- 原文链接:https://blog.zengrong.net/post/llm-api-slow-afternoon/
- 【公众号】曾嵘胡扯的地方:https://mp.weixin.qq.com/s/yWV9vcFPrKHC2rQhpn5MmQ
- 版权声明:本作品采用 署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0) 进行许可,非商业转载请注明出处(原文作者,原文链接),商业转载请联系作者获得授权。