阿里开源ACE++,无训练,一张图搞定换装,全面超越 LoRA? | 胡扯AI
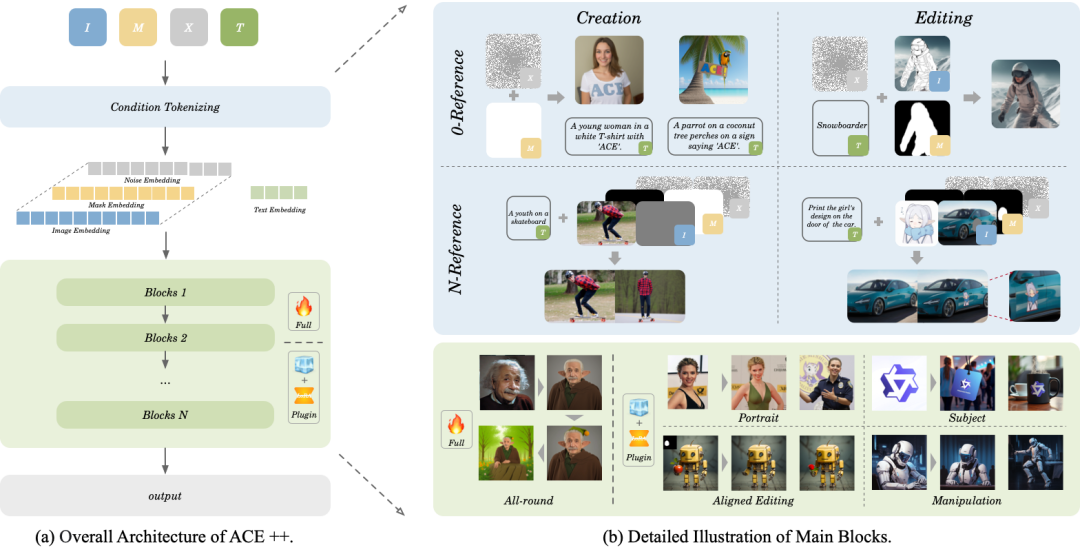
近日,阿里通义视觉实验室开源了 ACE++ 的代码和模型,同时也发布了 LoRA 的训练代码。
ACE++ 是通过上下文感知内容填充创建和编辑基于指令的图像的工具。简化训练,上传一张原始图搞定图像编辑。
ACE++ 鼓励开发人员根据自己的场景选择合适的模型,并使用特定场景中的数据微调模型,以获得更稳定的结果。
(图像范例见文章末尾)

简要说明
核心架构
基于指令驱动的扩散模型框架,采用两阶段训练方案:
- 预训练阶段:继承FLUX.1等文本到图像模型的生成能力
- 微调阶段:支持综合指令集处理,提供完整微调与轻量化微调双版本
技术创新
- 改进长上下文条件单元(LCU),实现多任务统一处理
- 利用图像生成先验知识,提升处理效率
- 支持全功能版和垂直领域专用版模型部署
应用场景演示
主题驱动生成:
- IP形象延展:将卡通角色融入游戏主机、包装设计等商业场景
- 品牌标识应用:展示商标在礼盒、数字广告牌等载体的多样化呈现
- 创意产品设计:毛绒玩具在都市、航海等主题环境中的多形态表现
人像一致性编辑:
- 角色换装:实时生成古风/超级英雄/职业装等多风格形象
- 场景迁移:人物无缝融入中国古建筑/沙漠/北极等背景
- 肖像风格化:支持迪士尼卡通化等艺术风格转换
灵活指令处理:
- 元素替换:服装颜色调整、物品增减
- 动态改造:交通工具火星行驶、海浪增强等场景特效
- 跨介质转换:照片转插画风格、现实转赛博朋克风格
局部精细编辑:
- 对象移除/修复:精准消除指定物体
- 区域着色:局部色彩调整
- 文本编辑:添加/去除指定文字
技术优势
- 支持自然语言指令和视觉参考双重引导
- 保持主体特征一致性
- 实现像素级精细控制
- 适配商业设计全流程需求
该框架已获CVPR 2025收录,相关技术细节可参考原始论文(arXiv:2501.02487)。
系统提供API接口和本地部署方案,满足不同规模企业的图像创作需求。
官网摘要原文和资源地址
- 官网地址: https://ali-vilab.github.io/ACE_plus_page/
- Github 地址: https://github.com/ali-vilab/ACE_plus
- 论文地址: https://arxiv.org/abs/2501.02487
- Demo地址: https://huggingface.co/spaces/scepter-studio/ACE-Plus
我们提出了ACE++,这是一个基于指令的扩散框架,能够处理多种图像生成和编辑任务。受FLUX.1-Fill-dev提出的修复任务输入格式启发,我们改进了ACE中引入的长上下文条件单元(Long-context Condition Unit, LCU),并将这一输入范式拓展到任意编辑和生成任务。为充分利用图像生成先验知识,我们开发了一个两阶段训练方案来最小化微调FLUX.1-dev等强大文本到图像扩散模型的工作量。
在第一阶段,我们使用文本到图像模型的0-ref任务数据进行预训练。社区中许多基于文本到图像基础模型后续训练的方法都符合这一阶段的训练范式,例如主要处理绘制任务的FLUX.1-Fill-dev可作为初始化来加速训练过程。在第二阶段,我们对上述模型进行微调以支持ACE定义的所有通用指令。为促进ACE++在不同场景的广泛应用,我们提供覆盖完整微调和轻量化微调的完整模型集合,同时兼顾通用适用性和垂直场景适用性。定性分析展现了ACE++在生成图像质量和指令跟随能力方面的优越性。
范例
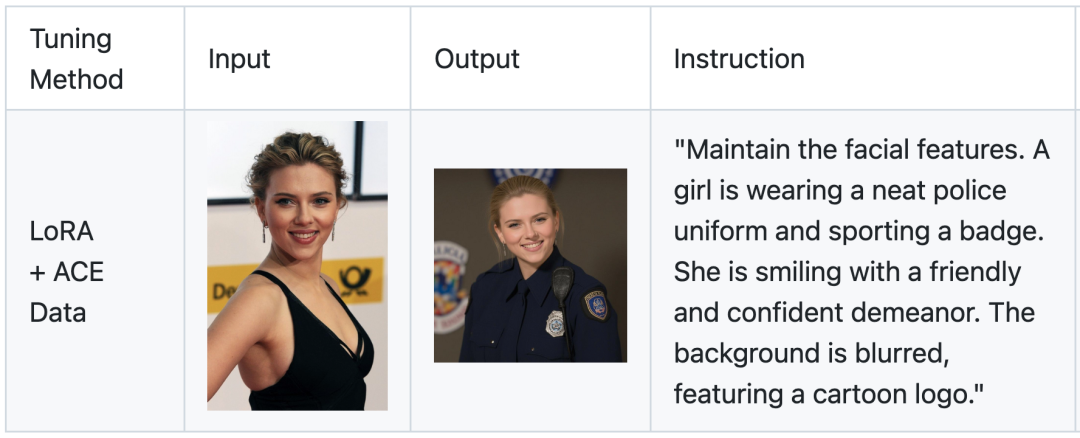
肖像
纵向一致性生成,以保持纵向的一致性。
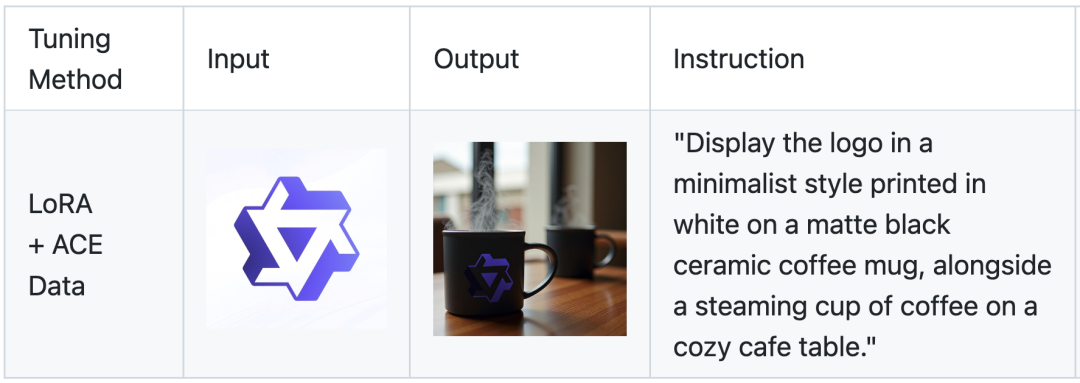
主体
主体驱动的图像生成任务,用于保持特定主体在不同场景中的一致性。
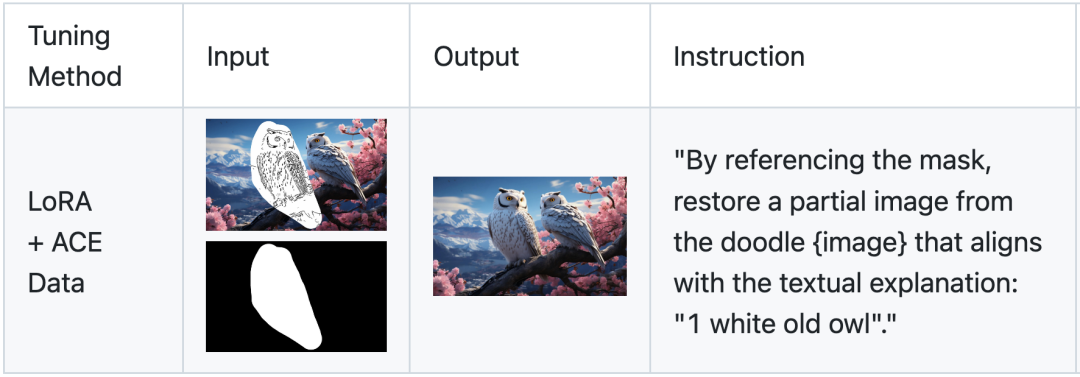
本地编辑
重新绘制图像的蒙版区域,同时保持编辑区域的原始结构信息。
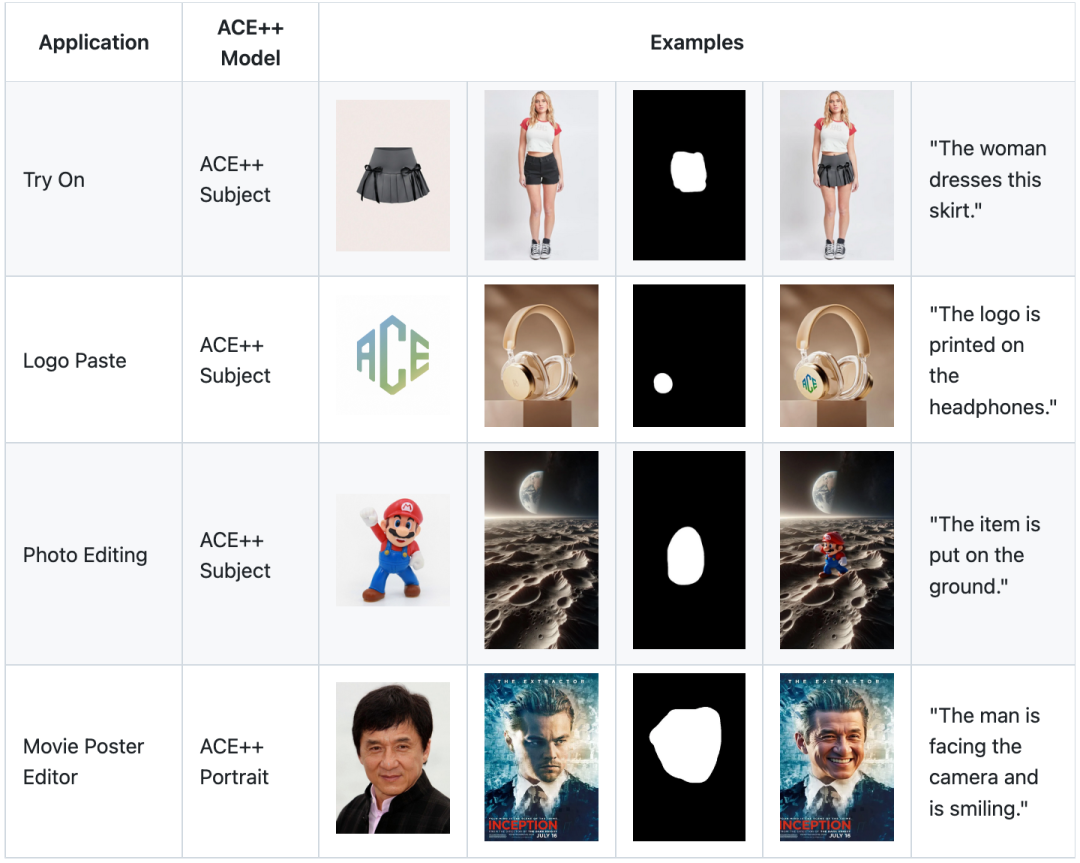
具体应用
ACE++ 模型通过简单的调整支持广泛的下游任务。以下是一些示例,我们期待看到社区探索更多利用 ACE++ 模型的令人兴奋的应用程序。
胡扯 AI 群,匹配游戏小团队创业,关注 AI 嵌入游戏工作流
当听到地铁上有人聊 ChatGPT,当 DeepSeek 把 OpenIAI 和 Gemini 卷到打骨折,我知道,将 AI 全面嵌入工作流的时机已经成熟了。
曾老师会持续专注于将 AI 深度整合进入工作流,有兴趣折腾的朋友可扫描下方二维码,一起在游戏创业路上持续精进。
- 文章ID:2983
- 原文作者:zrong(Jacky)
- 原文链接:https://blog.zengrong.net/post/alibaba-ace-plus-image-edit/
- 【公众号】曾嵘胡扯的地方:https://mp.weixin.qq.com/s/m1JV0I1EpYmpggkXApG-Bg
- 版权声明:本作品采用 署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0) 进行许可,非商业转载请注明出处(原文作者,原文链接),商业转载请联系作者获得授权。